Tre anni fa questo articolo elencava capacità che sembravano futuristiche. Oggi quelle stesse capacità sono nei telefoni di chiunque, nei flussi di lavoro di milioni di professionisti, negli strumenti che usi ogni giorno senza quasi accorgertene.
L’AI generativa non è più una promessa. È un’infrastruttura. Questo aggiornamento di ottobre 2026 riflette lo stato reale del campo: cosa è cambiato (quasi tutto), cosa rimane un limite irrisolto, e cosa significa per chi crea professionalmente.
Iniziamo dalle fondamenta, perché capire come funziona rimane il modo migliore per usarla bene.
AI Generativa vs AI Discriminativa: La Differenza che Conta
L’AI discriminativa risponde a “cos’è questo?”: classifica, categorizza, riconosce. Il sistema che identifica un tumore in una radiografia, quello che filtra le email spam, quello che riconosce la tua voce per sbloccare il telefono — tutti AI discriminativa.
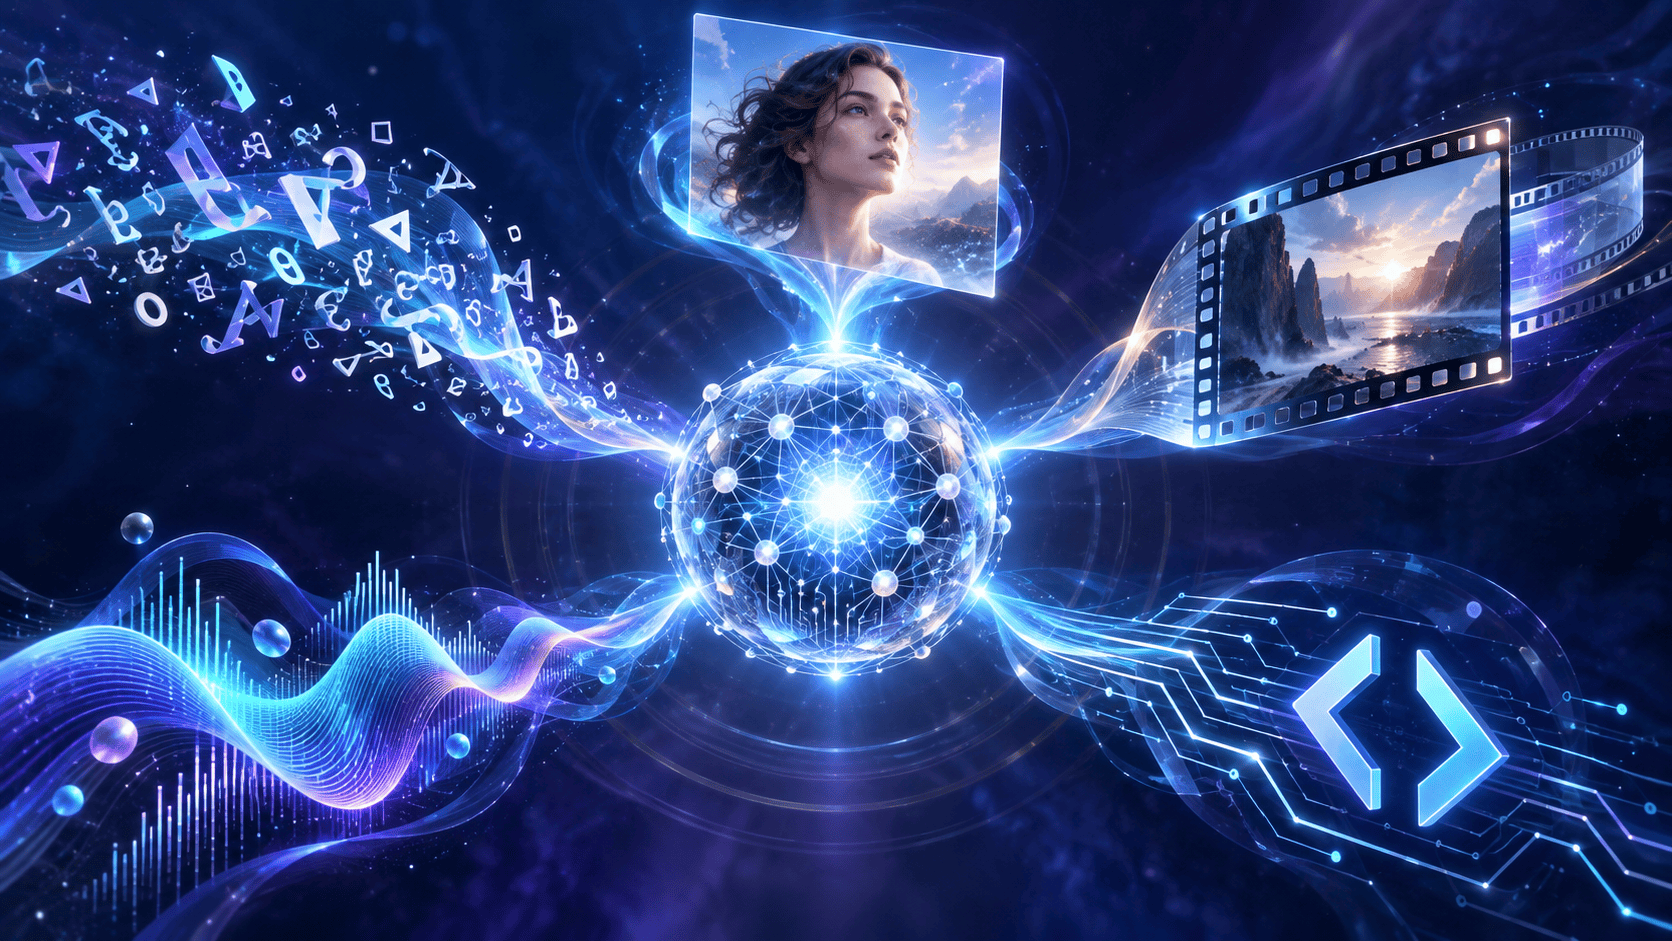
L’AI generativa risponde invece a “cosa potrebbe venire dopo?”. Dato un input — un testo, un’immagine, un prompt — produce qualcosa di nuovo: un testo, un’immagine, un video, un brano musicale. Non classifica l’esistente. Crea qualcosa che non esisteva.
Dal 2023 a oggi questa distinzione è diventata meno netta: i modelli di nuova generazione combinano entrambe le capacità. Claude Opus 5, GPT-4o e Gemini 2.5 capiscono testo, immagini e audio in input e generano testo in output. Non sono più semplici generatori — sono sistemi multimodali che percepiscono e producono. Ma la logica di base rimane: il loro valore è nella creazione, non solo nella classificazione.
Testo: I Grandi Modelli Linguistici nel 2026
Il panorama dei large language model è cambiato profondamente. I modelli oggi disponibili — Claude Opus 5 e Sonnet 5 di Anthropic, GPT-4o e o3 di OpenAI, Gemini 2.5 Pro di Google, LLaMA 4 di Meta — sono qualcosa di diverso rispetto alle versioni di due anni fa.
Non si tratta solo di miglioramenti incrementali. I modelli di quinta generazione ragionano: scompongono problemi complessi in passaggi, verificano le proprie risposte, riconoscono i propri limiti. Claude Opus 5 e o3 di OpenAI eccellono nei task che richiedono ragionamento strutturato — matematica, logica, analisi complessa — con un salto qualitativo misurabile rispetto alla generazione precedente.
Le capacità pratiche sono cambiate di conseguenza. Quello che gli LLM fanno bene oggi va ben oltre la scrittura: analisi di documenti lunghi (centinaia di migliaia di parole in un singolo contesto), ricerca autonoma sul web in tempo reale, esecuzione di codice, gestione di task multi-step. La guida al prompt engineering che trovi su questo blog è nata per la generazione precedente — vale la pena rileggerla con questi strumenti in mente.
Quello che rimane un limite irrisolto: l’allucinazione non è scomparsa, si è solo ridotta e resa più difficile da individuare. I modelli più capaci sbagliano meno frequentemente — ma quando sbagliano, lo fanno con più sicurezza. Il principio da applicare è invariato: verifica sempre le affermazioni fattuali specifiche, specialmente quelle che riguardano numeri, date e citazioni.
Immagini: La Qualità Cinematografica è Diventata la Norma
Nel 2023 i modelli di generazione immagini producevano risultati impressionanti con mani a sei dita e testi illeggibili. Nel 2026 il problema non è più la qualità — è distinguere l’output dall’originale fotografico o illustrato.
I player principali sono cambiati. Flux Pro 2 (Black Forest Labs) e Midjourney v7 producono immagini di qualità fotografica con controllo stilistico preciso. Adobe Firefly 4 si è affermato come lo standard per l’uso professionale, perché addestrato su contenuti con licenza — il che risolve il problema del copyright per chi lavora in contesti aziendali. Ideogram 3 ha risolto finalmente il problema del testo nelle immagini, aprendo la generazione a casi d’uso grafici che prima erano impossibili.
Il cambiamento più significativo non è nella qualità delle immagini ma nel controllo. I modelli di nuova generazione permettono di specificare composizione, prospettiva, stile, illuminazione con precisione che prima richiedeva iterazioni estenuanti. Un art director può oggi prototipare un’intera campagna visiva in un pomeriggio.
Le implicazioni per i settori creativi sono reali e complesse — ma non nel modo che i titoli allarmistici suggeriscono. I professionisti che usano questi strumenti non sono stati sostituiti: lavorano più velocemente, producono più varianti, si concentrano sulle decisioni creative invece che sull’esecuzione tecnica. La barriera che si è abbassata è quella di produzione, non quella di avere qualcosa da dire.
Video: La Frontiera Che Ha Fatto il Salto
Se c’è un’area dove il progresso dal 2023 a oggi sembra quasi impossibile da credere, è la generazione video. Nel 2023 producevamo 4 secondi di video con fisica sbalorditiva. Nel 2026 i modelli migliori generano sequenze di un minuto con coerenza visiva, fisica plausibile e qualità quasi cinematografica.
Sora di OpenAI — finalmente disponibile pubblicamente dopo un anno di accesso limitato — ha stabilito un nuovo standard. Runway Gen-4, Kling 2.0 di Kuaishou, Veo 2 di Google e Hailuo di MiniMax completano un ecosistema competitivo che tre anni fa non esisteva.
Quello che è cambiato non è solo la qualità ma il paradigma d’uso. Non generiamo più video da zero a partire da prompt testuali: integriamo reference image, controlliamo il movimento della camera, estraiamo stili da video esistenti, editiamo sequenze specifiche mantenendo la coerenza del resto. La produzione video si sta trasformando in un processo che assomiglia sempre più al montaggio — iterativo, controllato, preciso.
I limiti rimasti: la coerenza dei personaggi su sequenze lunghe è ancora il problema principale — un volto che cambia leggermente da scena a scena, un oggetto che sparisce tra un taglio e l’altro. La generazione audio sincronizzata resta separata. E il controllo narrativo preciso — far accadere esattamente quello che vuoi, quando vuoi — richiede ancora molta iterazione.
Ma per la produzione di contenuti marketing, spot brevi, promo di prodotto, prototype di campagne pubblicitarie: le implicazioni sono già pienamente operative. Non è fantascienza. È il flusso di lavoro di molte agenzie creative europee.
Audio e Musica: Il Binario che Ha Raggiunto la Maturità
La sintesi vocale ha raggiunto un punto dove la distinzione tra voce umana e sintetica è diventata un problema serio — non più un esercizio accademico. ElevenLabs v3 e i suoi concorrenti producono voci indistinguibili dall’originale, con emozione, pause e inflessioni naturali. La clonazione vocale da pochi minuti di audio è uno strumento che chiunque può usare oggi con una sottoscrizione mensile.
Sul fronte musicale, Suno v4 e Udio hanno trasformato la composizione da prompt. “Brano indie folk malinconico con chitarra acustica, voce femminile, produzione minimalista stile anni ’90” produce in 30 secondi qualcosa di ascoltabile — con struttura, arrangiamento, mix. Non è al livello di un compositore umano nella profondità emotiva. Ma per sonorizzazione di contenuti, jingle, tracce di background: il mercato dei musicisti da library è cambiato strutturalmente.
Le questioni legali sul copyright musicale rimangono irrisolte — forse ancora più urgenti ora che la qualità ha reso il problema più visibile. Alcune etichette discografiche hanno firmato accordi con le piattaforme AI per l’uso delle loro librerie. Altre sono ancora in tribunale. La giurisprudenza si sta formando in tempo reale.
Codice: Da Autocomplete ad Agente Autonomo
La generazione di codice ha fatto un salto categorico: da autocomplete intelligente ad agente che scrive, esegue, debugga e riscrive il proprio codice in loop. Claude Code, Cursor e GitHub Copilot nella sua versione agente possono oggi prendere una specifica in linguaggio naturale e produrre un’applicazione funzionante — non perfetta, ma funzionante.
Il vantaggio strutturale del codice rispetto al testo in linguaggio naturale rimane: il codice si verifica. Un testo che suona bene può essere sbagliato. Un codice che produce un errore lo mostra immediatamente. Questo rende il ciclo AI-sviluppatore più robusto di quanto sembri.
Chi guadagna di più da questi strumenti non sono i programmatori junior che speravano di usarli come scorciatoia — sono i senior developer che li usano per moltiplicare la propria produttività su task strutturati, liberando tempo per il design architetturale e le decisioni che richiedono giudizio. Il codice generato dall’AI ha ancora bisogno di qualcuno che sappia leggerlo.
Limiti, Rischi e la Questione del Copyright nel 2026
I limiti strutturali dell’AI generativa non sono scomparsi — si sono trasformati. I modelli continuano a non “capire” il mondo in senso profondo: predicono pattern statistici. Il rischio dell’allucinazione si è ridotto in frequenza ma aumentato in sofisticazione. I bias presenti nei dati di training si riflettono negli output in modi che spesso non sono immediatamente visibili.
Il problema dei deepfake è diventato strutturale. Con la qualità attuale della generazione video e vocale, produrre contenuti falsi convincenti richiede ore, non giorni. La risposta tecnologica — watermarking digitale, rilevatori AI — è in costante rincorsa. L’AI Act europeo ha introdotto obblighi di etichettatura per i contenuti sintetici, ma l’enforcement rimane una sfida operativa aperta.
Sul copyright: la situazione legale si è chiarita parzialmente. Negli USA, diverse cause hanno stabilito che i modelli addestrati su dati protetti possono violare il copyright — ma la giurisprudenza è ancora in evoluzione. In Europa, l’AI Act richiede trasparenza sui dati di training. Le aziende che vogliono usare AI generativa in contesti professionali hanno bisogno di strumenti che dichiarino chiaramente la provenienza dei dati di addestramento — e Firefly di Adobe è diventato lo standard de facto proprio per questo.
L’AI Generativa Amplifica Chi Ha Qualcosa da Dire
L’opportunità che l’AI generativa offre è reale e straordinaria: abbassa le barriere tecniche alla creazione, moltiplica la produttività di chi lavora con contenuti, rende accessibili strumenti prima riservati a chi aveva budget o competenze specifiche.
Ma c’è una distinzione fondamentale da tenere a mente: l’AI generativa abbassa le barriere alla produzione, non alla creatività nel suo senso più profondo. Generare un’immagine con Flux Pro è diverso dall’avere un punto di vista visivo da esprimere. Produrre un testo con Claude è diverso dall’avere qualcosa da dire. La prima capacità è ora accessibile a tutti — la seconda rimane il dominio di chi ha sviluppato una voce, una sensibilità, una prospettiva.
Gli strumenti migliori amplificano chi ha già qualcosa da dire. Inondano il mondo di rumore nelle mani di chi non ce l’ha. Quella distinzione non è tecnologica — è umana. E dipende da come scegliamo di usarli.
Come stai usando tu l’AI generativa nel tuo lavoro? Cosa ha cambiato davvero, e cosa non ha ancora cambiato? Scrivimi nei commenti.